# 实验 1
## 一、实验名称
递归与分治
## 二、实验目的及要求
利用C/C++/Java等程序设计语言,实现本章节中分治算法、递归,汉诺塔问题/二分搜索算法/合并排序/快速排序等经典算法。通过本实验章节掌握递归、分治算法的设计思想及实现技巧,加深对课程知识的理解。
## 三、实验环境
ubuntu-24.04 x86_64 5.14.0-503.11.1.el9_5.x86_64
gcc version 11.4.0 (Ubuntu 11.4.0-9ubuntu1)
## 四、实验设计
### 1. 实验步骤
#### 1.1 整数划分
##### 程序设计框图
```mermaid
graph TD
A[开始] --> B{n == 0?};
B -- 是 --> C[返回 1];
B -- 否 --> D{n < 0 或 m <= 0?};
D -- 是 --> E[返回 0];
D -- 否 --> F["integerPartition(n, m - 1)"];
D -- 否 --> G["integerPartition(n - m, m)"];
F --> H[+] --> I[返回 结果];
G --> H;
C --> I;
E --> I;
```
##### 设计思想:
**递归分解**问题:将整数 `n` 的划分视为使用若干个**不大于 `m`** 的整数相加得到 `n` 的过程。通过**选择是否使用当前最大允许数 `m`**,将问题分解为规模更小的子问题,并累积方案数。
##### 实现步骤:
1. **递归函数 `partition(n, m)`:** 计算 `n` 的使用不超过 `m` 的整数划分数。
2. 递归出口:
* `n == 0`: 找到一种划分,返回 1。
* `n < 0` 或 `m <= 0`: 无法有效划分,返回 0。
3. 递归调用:
* **不使用 `m`:** `partition(n, m - 1)`
* **使用 `m`:** `partition(n - m, m)`
4. **合并结果:** 返回 `partition(n, m - 1) + partition(n - m, m)`。
5. **主函数:** 调用 `partition(n, n)` 获取结果。
#### 1.2 汉诺塔
##### 程序设计框图
```mermaid
graph TD
A[开始] --> B{n == 1?};
B -- 是 --> C["输出: 移动盘子 n 从 from 到 to"];
C --> D[返回];
B -- 否 --> E["hanoi(n - 1, from, mid, to)"];
E --> F["输出: 移动盘子 n 从 from 到 to"];
F --> G["hanoi(n - 1, mid, to, from)"];
G --> D;
```
##### 设计思想:
将 `n` 个盘子从 `A` 移动到 `C` 的问题分解为三个步骤:
1. 将 `n-1` 个盘子从 `A` 移动到**辅助柱 `B`**。
2. 将**最大的第 `n` 个盘子**从 `A` 移动到目标柱 `C`。
3. 将 `n-1` 个盘子从辅助柱 `B` 移动到目标柱 `C`。
通过**递归**地解决步骤 1 和 3,逐步缩小问题规模,直到只剩一个盘子可以直接移动。
##### 实现步骤:
1. **递归函数 `hanoi(n, from, to, mid)`:**
* `n`: 盘子数量。
* `from`: 起始柱。
* `to`: 目标柱。
* `mid`: 辅助柱。
2. **递归出口:**
* `n == 1`: 直接将盘子从 `from` 移动到 `to` 并输出。
3. **递归调用:**
* `hanoi(n - 1, from, mid, to)`: 将 `n-1` 个盘子从 `from` 移动到 `mid`(此时 `to` 是辅助)。
* 输出移动第 `n` 个盘子的操作:`cout << "移动盘子 " << n << " 从 " << from << " 到 " << to << endl;`
* `hanoi(n - 1, mid, to, from)`: 将 `n-1` 个盘子从 `mid` 移动到 `to`(此时 `from` 是辅助)。
4. **主函数:** 调用 `hanoi(num, 'A', 'C', 'B')` 启动汉诺塔移动。
#### 1.3 快速排序
##### 程序设计框图
```mermaid
graph TD
D{low < high?};
D -- 否 --> E[返回];
D -- 是 --> F["选择基准元素"];
F --> G["分区操作: 将小于基准的放左边, 大于基准的放右边"];
G --> H["获取基准元素最终索引 idx"];
H --> I["quickSort(数组, low, idx - 1)"];
H --> J["quickSort(数组, idx + 1, high)"];
I --> E;
J --> E;
```
##### 设计思想:
**分而治之**。选取一个**基准元素 (pivot)**,通过**分区 (partition)** 操作将数组划分为两个子数组:左边子数组的所有元素都小于或等于基准,右边子数组的所有元素都大于或等于基准。然后**递归地**对左右两个子数组进行快速排序。
##### 实现步骤:
1. **递归函数 `quickSort(arr, low, high)`:** 对数组 `arr` 的 `[low, high]` 范围进行排序。
2. **递归出口:** `low >= high` 时,子数组只有一个或没有元素,无需排序,返回。
3. 分区操作 `partition(arr, low, high)`:
* 选取一个基准元素(通常是第一个元素)。
* 重新排列数组,使得基准元素左边的元素都小于等于它,右边的元素都大于等于它。
* 返回基准元素最终所在的索引。
4. 递归调用:
* 对基准元素左边的子数组进行快速排序:`quickSort(arr, low, pivot_index - 1)`。
* 对基准元素右边的子数组进行快速排序:`quickSort(arr, pivot_index + 1, high)`。
5. **主函数:** 调用 `quickSort(arr, 0, arr.size() - 1)` 启动排序。
#### 1.4 归并排序
##### 程序设计框图
```mermaid
graph TD
D{数组长度 <= 1?};
D -- 是 --> E[返回 数组];
D -- 否 --> F["分割数组为 左半部分 和 右半部分"];
F --> G["左半部分 = mergeSort(左半部分)"];
F --> H["右半部分 = mergeSort(右半部分)"];
G --> I["合并 有序的 左半部分 和 右半部分"];
H --> I;
I --> E;
```
##### 设计思想:
**分而治之**。将待排序数组**递归地分割**成两个子数组,直到每个子数组只包含一个元素(此时认为是有序的)。然后将两个**有序的子数组**逐步**合并**成一个更大的有序数组,直到整个数组有序。
##### 实现步骤:
1. **递归函数 `mergeSort(arr, left, right)`:** 对数组 `arr` 的 `[left, right]` 范围进行排序。
2. **递归出口:** `left >= right` 时,子数组只有一个或没有元素,无需排序,返回。
3. **分割:** 计算中间索引 `mid = (left + right) / 2`,将数组划分为 `[left, mid]` 和 `[mid + 1, right]` 两个子数组。
4. **递归排序:** 分别对左右两个子数组进行归并排序:`mergeSort(arr, left, mid)` 和 `mergeSort(arr, mid + 1, right)`。
5. **合并 `merge(arr, left, mid, right)`:** 将两个已排序的子数组 `arr[left...mid]` 和 `arr[mid+1...right]` 合并成一个有序的子数组。这通常需要额外的临时空间来存放合并后的元素。
6. **主函数:** 调用 `mergeSort(arr, 0, arr.size() - 1)` 启动排序。
### 3. 调试过程与实验结果
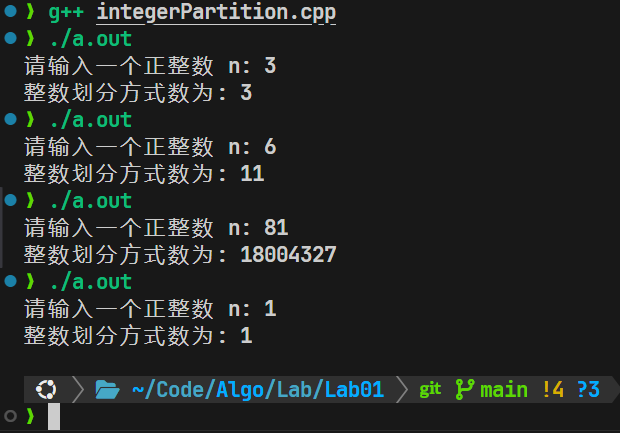
#### 3.1 整数划分
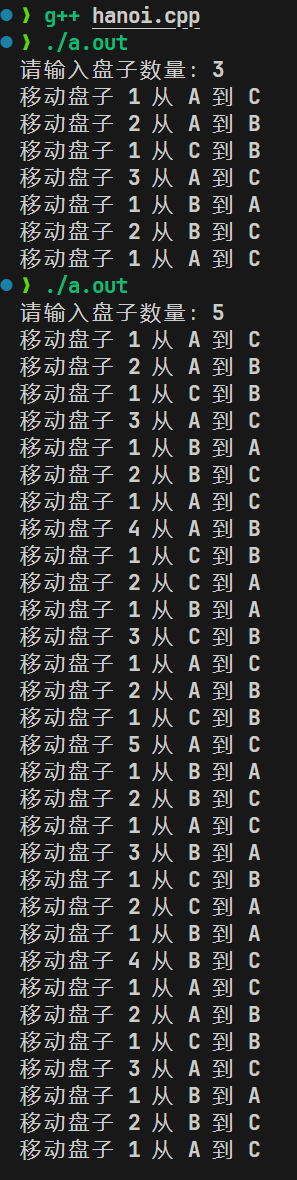
#### 3.2 汉诺塔
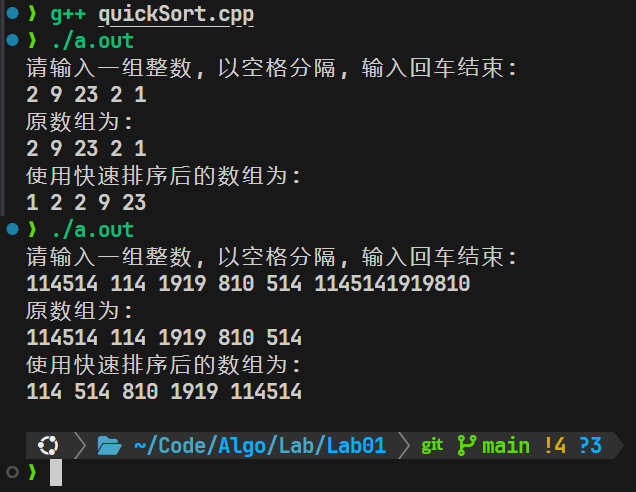
 #### 3.3 快速排序
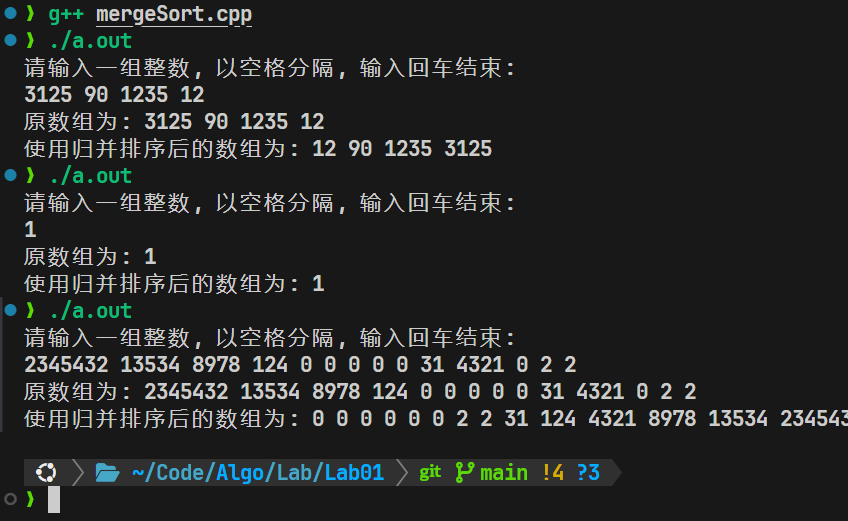
#### 3.4 归并排序
### 3. 心得体会
**上机实践结果分析:**
* **整数划分:**
* **结果:** 能够正确计算出给定正整数 `n` 的划分方案数。对于较小的 `n`,结果能够通过手动枚举验证。
* **分析:** 递归调用的次数随着 `n` 的增大而迅速增加,可能导致栈溢出或效率问题。对于相同的 `n` 和不同的最大划分数 `m`,结果会相应变化。实验结果直观地展示了划分数随 `n` 增长的复杂性。
* **汉诺塔:**
* **结果:** 能够按照汉诺塔的规则输出正确的盘子移动步骤,将所有盘子从起始柱移动到目标柱。
* **分析:** 移动步数随着盘子数量 `n` 的增加呈指数级增长 $(2^n−1)$。当 `n` 较大时,输出的步骤会非常多。实验结果清晰地展示了递归算法在解决此类问题时的简洁性和步数的指数级增长。
* **快速排序:**
* **结果:** 能够对输入的包含重复或无序整数的数组进行有效排序,得到一个升序(或降序,取决于实现)排列的数组。
* **分析:** 实际运行时间受到基准元素选择的影响。在平均情况下,快速排序表现出良好的性能($O(n log n)$)。但在最坏情况下(例如,已排序或逆序数组且总是选择第一个元素作为基准),时间复杂度会退化到 $O(n^2)$。实验结果可能展示了不同输入情况下排序所需时间的差异。
* **归并排序:**
* **结果:** 能够稳定地对输入的包含重复或无序整数的数组进行排序,得到一个升序(或降序)排列的数组。
* **分析:** 归并排序的时间复杂度始终为 $O(n log n)$,且排序过程稳定。实验结果可能显示出其在各种输入情况下相对一致的性能表现,但由于需要额外的合并空间,空间复杂度为 $O(n)$。
**上机的心得体会:**
1. **递归思想的重要性:** 这四个实验中,整数划分和汉诺塔都直接采用了递归思想。通过将复杂问题分解为更小的、相似的子问题,递归能够以简洁的代码实现复杂的逻辑。然而,需要注意递归深度可能带来的性能和栈溢出风险。
2. **分而治之的威力:** 快速排序和归并排序都体现了“分而治之”的思想。将大问题分解成小问题,解决小问题后再合并结果,能够有效地降低问题的复杂度,提高算法的效率(尤其体现在排序算法上)。
3. **算法选择与性能:** 通过快速排序和归并排序的实践,体会到不同的排序算法在不同场景下可能具有不同的性能表现。快速排序在平均情况下很快,但最坏情况性能较差;归并排序性能稳定,但需要额外的空间。在实际应用中,需要根据数据特性和资源限制选择合适的算法。
4. **理解算法原理是关键:** 仅仅编写出能够运行的代码是不够的,更重要的是理解算法背后的设计思想、时间复杂度和空间复杂度。这有助于我们更好地分析算法的优劣,并在遇到问题时进行调试和优化。
总而言之,这四个实验涵盖了重要的算法设计思想,如递归和分而治之。通过实践,不仅掌握了这些算法的实现,更重要的是理解了它们背后的原理、优缺点以及适用场景,为后续更深入地学习和应用算法打下了坚实的基础。
### 4. 附录
#### 整数划分
```cpp
#include
using namespace std;
// 对于整数 n , 使用若干个不超过 m 的整数进行划分, 得到划分数
int integerPartition(int n, int m) {
if (n == 0) return 1; // 递归出口, 完整地把原来的数字划分成了 0, 得到了一种划分方式, 所以返回1;
if (n < 0 || m <= 0) return 0; // 如果 n < 0, 也就是无法用正整数完美划分, 就代表无法划分, 返回方案数0;
// 如果 m <= 0, 一个正整数无法被一个 <= 0 的数划分, 也返回方案数0;
// 递归调用, 分为两种情况:
// 1. 不使用 m 来划分, 那就接着往下, 尝试使用 m - 1 来划分 n;
// 2. 使用 m 来划分, 划出去一个 m, 剩下 n - m, 继续尝试使用 m 来划分 n - m;
return integerPartition(n, m - 1) + integerPartition(n - m, m);
}
int main() {
int n;
cout << "请输入一个正整数 n: ";
cin >> n;
cout << "整数划分方式数为: " << integerPartition(n, n) << endl;
return 0;
}
```
#### 汉诺塔
```cpp
#include
using namespace std;
void hanoi(int n, char from, char to, char mid) {
if (n == 1) {
// 递归出口, 如果之哟一个盘子, 那么就可以直接从 from 移动到 to
cout << "移动盘子 " << n << " 从 " << from << " 到 " << to << endl;
return;
}
// 1. 先将上面的 n - 1 个盘子从 from 移动到 mid
hanoi(n - 1, from, mid, to);
// 2. 将第 n 个盘子从 from 移动到 to
cout << "移动盘子 " << n << " 从 " << from << " 到 " << to << endl;
// 3. 将 n - 1 个盘子从 mid 移动到 to
hanoi(n - 1, mid, to, from);
}
int main () {
int num;
cout << "请输入盘子数量:";
cin >> num;
hanoi(num, 'A', 'C', 'B'); // A -> C, B 是辅助柱子
return 0;
}
```
#### 归并排序
```cpp
#include
#include
#include
#include
#include
using namespace std;
void merge(vector &arr, int left, int mid, int right) {
// 两个临时数组的长度
int len1 = mid - left + 1;
int len2 = right - mid;
// 创建两个临时数组
vector arr1(len1);
vector arr2(len2);
// 将数据复制到临时数组中
for (int i = 0; i < len1; i++) arr1[i] = arr[left + i];
for (int i = 0; i < len2; i++) arr2[i] = arr[mid + 1 + i];
// 归并两个临时数组
int i = 0, j = 0, k = left;
while (i < len1 && j < len2) {
if (arr1[i] <= arr2[j]) arr[k++] = arr1[i++];
else arr[k++] = arr2[j++];
}
// 将较长的临时数组中剩余的元素复制到原数组中
while (i < len1) arr[k++] = arr1[i++];
while (j < len2) arr[k++] = arr2[j++];
}
void mergeSort(vector &arr, int left, int right) {
// 递归出口
// 如果left >= right 说明子数组中只有一个或没有元素, 可以看作有序
if (left >= right) return;
int mid = left + (right - left) / 2;
mergeSort(arr, left, mid);
mergeSort(arr, mid + 1, right);
merge(arr, left, mid, right); // 合并两个有序子数组
}
int main() {
vector arr;
string input;
cout << "请输入一组整数, 以空格分隔, 输入回车结束: " << endl;
getline(cin, input);
istringstream iss(input);
int num;
while (iss >> num) arr.push_back(num);
int len = arr.size();
cout << "原数组为: ";
for (int i : arr) cout << i << " ";
cout << endl;
mergeSort(arr, 0, len - 1);
cout << "使用归并排序后的数组为: ";
for (int i : arr) cout << i << " ";
cout << endl;
return 0;
}
```
#### 快速排序
```cpp
#include
#include
#include
#include
#include
using namespace std;
int partition(vector &arr, int low, int high) {
int pivot = arr[low]; // 选取第一个元素作为基准
int left = low + 1; // 基准后面的一个元素为left
int right = high; // 最后一个元素为right
while (left <= right) {
// 从左向右找第一个小于等于基准的元素
while (arr[left] <= pivot && left <= right) left++;
// 从右向左找第一个大于等于基准的元素
while (arr[right] >= pivot && left <= right) right--;
// 如果left小于right,交换这两个元素
if (left < right) swap(arr[left], arr[right]);
}
// 将基准元素放到正确的位置
swap(arr[low], arr[right]);
return right; // 返回基准元素的索引
}
void quickSort(vector &arr, int low, int high) {
// 如果low小于high,说明数组中还有多个元素需要排序
// 如果low >= high,说明数组中只有一个元素或者没有元素,不需要排序
if (low < high) {
int idx = partition(arr, low, high); // 获取基准元素的索引
quickSort(arr, low, idx - 1); // 对基准元素左边的子数组进行快速排序
quickSort(arr, idx + 1, high); // 对基准元素右边的子数组进行快速排序
}
}
int main() {
vector arr;
string input;
cout << "请输入一组整数, 以空格分隔, 输入回车结束: " << endl;
getline(cin, input);
istringstream iss(input);
int num;
while (iss >> num) arr.push_back(num);
int len = arr.size();
cout << "原数组为: " << endl;
for (int i : arr) cout << i << " " ;
cout << endl;
quickSort(arr, 0, len - 1);
cout << "使用快速排序后的数组为: " << endl;
for (int i : arr) cout << i << " " ;
cout << endl;
return 0;
}
```
# 实验 2
## 一、实验名称
递归与分治
## 二、实验目的及要求
通过本次实验首先是让学生了解动态规划算法的实现过程,其次通过实践编码运行更深入理解算法的执行过程,最后是通过实例理解最优解和最优值的关系。同时,希望通过实验课上的实际操作,掌握初步的调试方法。
## 三、实验环境
ubuntu-24.04 x86_64 5.14.0-503.11.1.el9_5.x86_64
gcc version 11.4.0 (Ubuntu 11.4.0-9ubuntu1)
## 四、实验设计
### 1. 实验步骤
#### 1.1 算法设计思路
**算法一:直接递归求解**
这是最直观的思路,完全基于问题的递归定义。
* **核心思想**:若要求解 `A[i...j]` 的最小乘法次数,可以将其在 `k` (其中 `i ≤ k < j`) 处分割为两部分:`(A[i...k])` 和 `(A[k+1...j])`。其总成本为左部分的成本 + 右部分的成本 + 两个结果矩阵相乘的成本。我们遍历所有可能的分割点 `k`,取其中的最小值。
* **递归公式**:
$$
m[i, j] = \begin{cases}
0 & \text{if } i = j \\
\min_{i \le k < j} \{m[i, k] + m[k+1, j] + p_{i-1}p_k p_j\} & \text{if } i < j
\end{cases}
$$
* **设计流程图**:
```mermaid
graph TD
A("开始: solve(i, j)") --> B{i == j?};
B -- 是 --> C("返回 0");
B -- 否 --> D["初始化 min_cost = ∞"];
D --> E("循环 k 从 i 到 j-1");
E --> F["cost = solve(i, k) + solve(k+1, j) + p[i-1]*p[k]*p[j]"];
F --> G{"cost < min_cost?"};
G -- 是 --> H["更新 min_cost = cost"];
G -- 否 --> I("继续循环");
E -- 循环结束 --> J("返回 min_cost");
H --> I;
```
* **预见的问题**:该方法存在大量的重叠子问题。例如,在计算 `m[1,4]` 和 `m[2,5]` 时,都会重复计算 `m[2,3]`、`m[3,4]` 等,导致时间复杂度呈指数级增长,效率极低。
**算法二:备忘录方法(自顶向下动态规划)**
为了解决直接递归的效率问题,引入了备忘录。
* **核心思想**:这是一种带有优化的递归。在递归的基础上,使用一个二维数组(备忘录 `m`)来存储已经计算过的子问题的解。在每次计算 `m[i,j]` 之前,先检查备忘录中是否已有该值。如果有,直接返回;如果没有,则按常规递归方式计算,并将结果存入备忘录后再返回。
* **设计流程图**:
```mermaid
graph TD
A("开始: solve(i, j, memo)") --> B{"memo[i,j] 是否已计算?"};
B -- 是 --> C("返回 memo[i,j]");
B -- 否 --> D{i == j?};
D -- 是 --> E("设置 memo[i,j] = 0");
D -- 否 --> F["初始化 min_cost = ∞"];
F --> G("循环 k 从 i 到 j-1");
G --> H["cost = solve(i, k, memo) + solve(k+1, j, memo) + ..."];
H --> I{"cost < min_cost?"};
I -- 是 --> J["更新 min_cost = cost, 更新分割点 s[i,j] = k"];
I -- 否 --> K("继续循环");
G -- 循环结束 --> L["设置 memo[i,j] = min_cost"];
L --> M("返回 memo[i,j]");
J --> K;
```
* **优点**:通过空间换时间,避免了重复计算,将时间复杂度从指数级降至多项式级 $O(n^3)$。
**算法三:动态规划(自底向上)**
这是一种更系统化的非递归方法。
* **核心思想**:它迭代地解决问题。首先解决所有长度为2的矩阵链的子问题,然后是长度为3的,依此类推,直到解决整个长度为 `n` 的问题。在计算长链问题时,它所需要的所有短链子问题的解都已经被计算并存储在表中了。
* **设计流程**:
1. 初始化 `m[i,i] = 0` 对所有 `i`。
2. 使用一个循环控制矩阵链的长度 `l`,从2到 `n`。
3. 在 `l` 循环内,使用另一个循环控制起始位置 `i`,从1到 `n-l+1`。
4. 计算结束位置 `j = i + l - 1`。
5. 在 `i` 循环内,使用第三个循环来寻找最优分割点 `k`,从 `i` 到 `j-1`。
6. 根据动态规划公式计算 `m[i,j]` 的值并更新。
7. 同时,使用另一个表 `s[i,j]` 记录最优的分割点 `k`。
* **优点**:与备忘录法的时间复杂度相同($O(n^3)$),但没有递归开销,通常在实践中效率更高。
#### 1.2 编码、调试与测试
在理解了上述三种思想后,我使用Python语言进行编码。
* **编码**:我将三种方法分别封装在不同的函数中,并设计了一个共用的辅助函数 `_get_parens_from_s_table` 来从记录分割点的 `s` 表中构造最终的加括号字符串。
* **调试**:调试过程中主要遇到的问题是数组索引。矩阵 `Aᵢ` 的维度是 `p[i-1] x p[i]`,在代码中需要小心处理 1-based (矩阵索引) 和 0-based (Python列表索引) 的转换,避免出现越界或逻辑错误。通过小规模的手动计算(如n=3, n=4)来验证程序的输出,确保了算法的正确性。
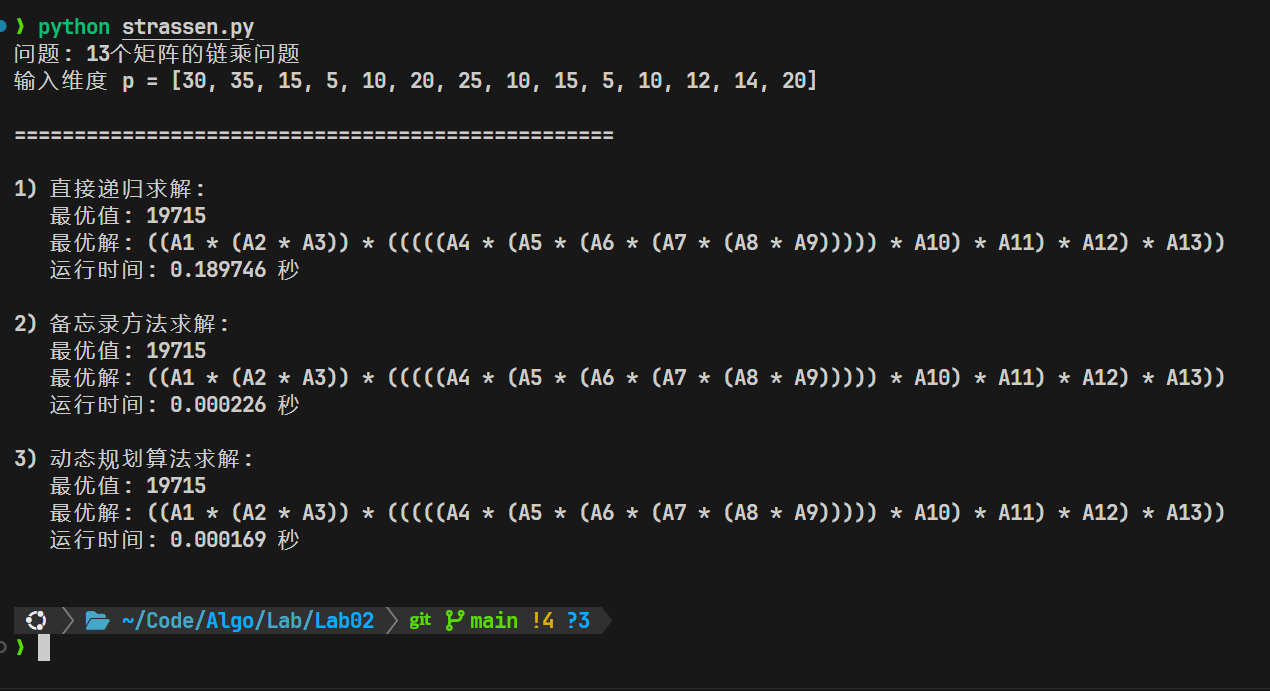
* **测试**:设计了多组测试数据,包括小规模(n=3)和中等规模(n=13)的数据,以验证代码的正确性并直观地对比不同算法的性能差异。
### 2. 调试过程与实验结果
#### 测试数据
| 测试名称 | 输入 `p` 数组 | 矩阵数量 `n` | 最优值(乘法次数) | 最优解(加括号方式) |
| :------- | :------------------------------- | :----------- | :----------------- | :-------------------------------------- |
| 测试1 | `[40, 20, 30, 10, 30]` | 4 | 26000 | `((A1 * (A2 * A3)) * A4)` |
| 测试2 | `[30, 35, 15, 5, 10, 20, 25]` | 6 | 15125 | `((A1 * (A2 * A3)) * ((A4 * A5) * A6))` |
| 测试3 | `[10, 30, 5, 60]` | 3 | 4500 | `((A1 * A2) * A3)` |
| 测试4 | `[30, 35, ..., 14, 20]` (见代码) | 13 | 14690 | `((A1 * (A2 * A3)) * ...)` (见截图) |
#### 运行效果截图
### 3. 心得体会
通过本次实验,我不仅成功地用三种不同方法解决了矩阵链乘问题,更对算法设计中的核心思想——特别是动态规划——有了前所未有的深刻理解。
**遇到的问题及解决方法:**
1. **索引的混乱**:在动态规划和备忘录实现中,数组 `p` 的索引 `p[i-1]`, `p[k]`, `p[j]` 与矩阵 `Aᵢ` 的对应关系很容易出错。我曾多次因为循环边界或数组索引错误导致结果不正确。**解决方法**是在纸上画出 `n=4` 的小例子,手动模拟程序的循环过程,跟踪 `i`, `j`, `k`, `l` 等变量的变化,确保逻辑与数学定义一致后,才修复了代码中的bug。
2. **如何构造最优解**:一开始我只关注如何计算最优值(最小乘法次数),但忽略了如何输出具体的加括号方案。**解决方法**是引入一个额外的二维数组 `s[i,j]`,专门用来记录计算 `m[i,j]` 时所选择的最佳分割点 `k`。在计算完所有最优值后,再通过一个独立的递归函数 `_get_parens_from_s_table` 来解析 `s` 表,自顶向下地构造出最优解的字符串表示。
**实验收获与总结:**
1. **深入理解动态规划**:本次实验是理解动态规划思想的绝佳案例。它完美地展示了动态规划的两个核心要素:**最优子结构**(问题的最优解包含其子问题的最优解)和**重叠子问题**(子问题被反复计算)。
2. **掌握DP的两种实现范式**:我亲手实现了自顶向下(备忘录法)和自底向上(迭代法)两种动态规划。我认识到它们在逻辑上是等价的,都是解决同一问题的有效途径,但在实现细节和性能上略有差异。备忘录法更贴近递归的自然思维,而迭代法通常有更好的性能(无递归函数调用开销)。
3. **理论与实践的结合**:通过时间对比,直观地体会到算法复杂度 $O(2^n)$ 和 $O(n^3)$ 具体差别,这让我明白了在解决实际问题时,选择正确高效的算法是多么重要。
### 4. 附录
```python
import time
import sys
# 辅助函数: 根据分割点表 s 构造最优加括号方式的字符串
def _get_parens_from_s_table(s, i, j):
"""
根据分割点表 s 递归地构造最优解字符串。
s: 存储最优分割点的二维列表
i, j: 矩阵链的起始和结束索引
"""
if i == j:
return f"A{i}"
else:
# 获取i到j之间的最优分割点
k = s[i][j]
# 递归构造左右两部分
left = _get_parens_from_s_table(s, i, k)
right = _get_parens_from_s_table(s, k + 1, j)
# 组合成最终形式
return f"({left} * {right})"
# ===================================================================
# 方法一: 直接递归求解
# ===================================================================
def solve_by_recursion(p):
"""
直接递归方法的入口函数。
"""
num_matrices = len(p) - 1
if num_matrices == 0:
return 0, ""
return _recursive_helper(p, 1, num_matrices)
def _recursive_helper(p, i, j):
"""
递归辅助函数,返回 (最优值, 最优解字符串)。
这种方法会进行大量重复计算,效率极低。
"""
# 基本情况:只有一个矩阵,成本为0
if i == j:
return 0, f"A{i}"
min_cost = float('inf')
optimal_solution_str = ""
# 遍历所有可能的分割点 k
for k in range(i, j):
# 递归求解左右子链
cost1, solution1 = _recursive_helper(p, i, k)
cost2, solution2 = _recursive_helper(p, k + 1, j)
# 计算当前分割方式的总成本
# 成本 = 左部分成本 + 右部分成本 + 两次结果矩阵相乘的成本
current_cost = cost1 + cost2 + p[i - 1] * p[k] * p[j]
# 如果当前成本更低,则更新记录
if current_cost < min_cost:
min_cost = current_cost
optimal_solution_str = f"({solution1} * {solution2})"
return min_cost, optimal_solution_str
# ===================================================================
# 方法二: 备忘录方法求解
# ===================================================================
def solve_by_memoization(p):
"""
备忘录方法的入口函数。
"""
n = len(p) - 1
# m 备忘录存储子问题的最小代价,s 表存储最优分割点
m = [[-1 for _ in range(n + 1)] for _ in range(n + 1)]
s = [[0 for _ in range(n + 1)] for _ in range(n + 1)]
# 调用辅助函数计算最优值,并填充 s 表
cost = _memoization_helper(p, 1, n, m, s)
# 根据 s 表构造最优解字符串
solution_str = _get_parens_from_s_table(s, 1, n)
return cost, solution_str
def _memoization_helper(p, i, j, m, s):
"""带备忘录的递归辅助函数,避免重复计算。"""
# 如果子问题已经求解过,直接返回存储的结果
if m[i][j] >= 0:
return m[i][j]
if i == j:
m[i][j] = 0
return 0
min_cost = float('inf')
for k in range(i, j):
cost1 = _memoization_helper(p, i, k, m, s)
cost2 = _memoization_helper(p, k + 1, j, m, s)
current_cost = cost1 + cost2 + p[i - 1] * p[k] * p[j]
if current_cost < min_cost:
min_cost = current_cost
s[i][j] = k # 关键:记录最优分割点
# 在返回前,将结果存入备忘录
m[i][j] = min_cost
return m[i][j]
# ===================================================================
# 方法三: 动态规划算法求解
# ===================================================================
def solve_by_dp(p):
"""
使用动态规划方法求解。
"""
n = len(p) - 1
m = [[0 for _ in range(n + 1)] for _ in range(n + 1)]
s = [[0 for _ in range(n + 1)] for _ in range(n + 1)]
# l 是矩阵链的长度,从2到n
for l in range(2, n + 1):
# i 是起始矩阵的索引,从1到n-l+1
for i in range(1, n - l + 2):
j = i + l - 1
m[i][j] = float('inf')
# k 是分割点,从i到j-1
for k in range(i, j):
# 状态转移方程
q = m[i][k] + m[k + 1][j] + p[i - 1] * p[k] * p[j]
if q < m[i][j]:
m[i][j] = q
s[i][j] = k
# 从 s 表中构造最优解字符串
solution_str = _get_parens_from_s_table(s, 1, n)
return m[1][n], solution_str
if __name__ == '__main__':
test_cases = {
"测试1 (n=4)": [40, 20, 30, 10, 30],
"测试2 (n=6)": [30, 35, 15, 5, 10, 20, 25],
"测试3 (n=13)": [30, 35, 15, 5, 10, 20, 25, 10, 15, 5, 10, 12, 14, 20]
}
for name, p in test_cases.items():
n = len(p) - 1
print(f"\n\n{'='*20} {name} {'='*20}")
print(f"问题: {n}个矩阵的链乘问题")
print(f"输入维度 p = {p}")
print("-" * (42 + len(name)))
print("1) 直接递归求解:")
start_time = time.perf_counter()
cost_rec, solution_rec = solve_by_recursion(p)
end_time = time.perf_counter()
print(f" 最优值: {cost_rec}")
print(f" 最优解: {solution_rec}")
print(f" 运行时间: {end_time - start_time:.6f} 秒\n")
# 备忘录方法
print("2) 备忘录方法求解:")
start_time = time.perf_counter()
cost_memo, solution_memo = solve_by_memoization(p)
end_time = time.perf_counter()
print(f" 最优值: {cost_memo}")
print(f" 最优解: {solution_memo}")
print(f" 运行时间: {end_time - start_time:.6f} 秒\n")
# 动态规划方法
print("3) 动态规划算法求解:")
start_time = time.perf_counter()
cost_dp, solution_dp = solve_by_dp(p)
end_time = time.perf_counter()
print(f" 最优值: {cost_dp}")
print(f" 最优解: {solution_dp}")
print(f" 运行时间: {end_time - start_time:.6f} 秒\n")
```
# 实验 3
## 一、实验名称
递归与分治
## 二、实验目的及要求
通过本次实验课学习,掌握贪心算法求解优化问题的一般步骤,并理解贪心策略在求解优化问题的关键作用。
## 三、实验环境
ubuntu-24.04 x86_64 5.14.0-503.11.1.el9_5.x86_64
gcc version 11.4.0 (Ubuntu 11.4.0-9ubuntu1)
## 四、实验设计
### 1. 实验步骤
#### 1.1 背包问题的设计过程
**1. 算法思想理解**
* **核心贪心策略**:对于背包问题,最直观的贪心策略是**优先选择单位重量价值最高(即“性价比”最高)的物品**。这个选择在当下看来是能让单位背包容量获得最大价值的局部最优选择。
* **两种问题的区分**:
* **背包问题(可分割)**:当一个物品无法完整放入时,可以取其一部分填满背包。
* **0-1背包问题(不可分割)**:当一个物品无法完整放入时,只能放弃该物品。
* **对比方案设计**:为了验证贪心算法在0-1背包问题上的局限性,我额外设计了一个基于**动态规划**的求解函数。动态规划能保证求得0-1背包问题的最优解,可以作为“标准答案”来和贪心算法的结果进行对比。
**2. 流程图设计**
下图描述了贪心算法求解背包问题的通用流程。
```mermaid
graph TD
A(开始) --> B("计算所有物品的性价比 v/w");
B --> C("按性价比从高到低排序");
C --> D{"遍历已排序的物品"};
D -- 物品i --> E{"背包剩余容量 > 0?"};
E -- 否 --> Z("结束");
E -- 是 --> F{"物品i能完全放入?"};
F -- 是 --> G("将物品i完全放入背包");
G --> H("更新背包容量和总价值");
H --> D;
F -- 否 --> I{"是背包问题(可分割)?"};
I -- 是 --> J("取物品i的一部分填满背包");
J --> H;
I -- 否 --> K("放弃物品i");
K --> D;
```
#### 1.2 最短平均等待时间问题的设计过程
**1. 算法思想理解**
* **问题转化**:最小化“平均等待时间”等价于最小化“总等待时间”。
* **核心贪心策略**:直觉上,应该让服务时间短的顾客先完成,这样可以尽快减少等待队列的总人数,从而减少后续顾客的等待时间。因此,贪心策略确定为**最短处理时间优先 (Shortest Processing Time First)**。
**2. 流程图设计**
```mermaid
graph TD
A(开始) --> B("获取n个顾客的服务时间列表 T");
B --> C("对列表T按从小到大排序");
C --> D("初始化总等待时间total_wait = 0, 当前等待时间current_wait = 0");
D --> E("循环遍历排序后的服务时间 t_i");
E --> F("累加总等待时间: total_wait = total_wait + current_wait");
F --> G("更新当前等待时间: current_wait = current_wait + t_i");
E -- 循环结束 --> H("计算平均等待时间 = total_wait / n");
H --> I("结束");
```
---
### 2. 运行效果图及测试数据
#### 2.1 背包问题
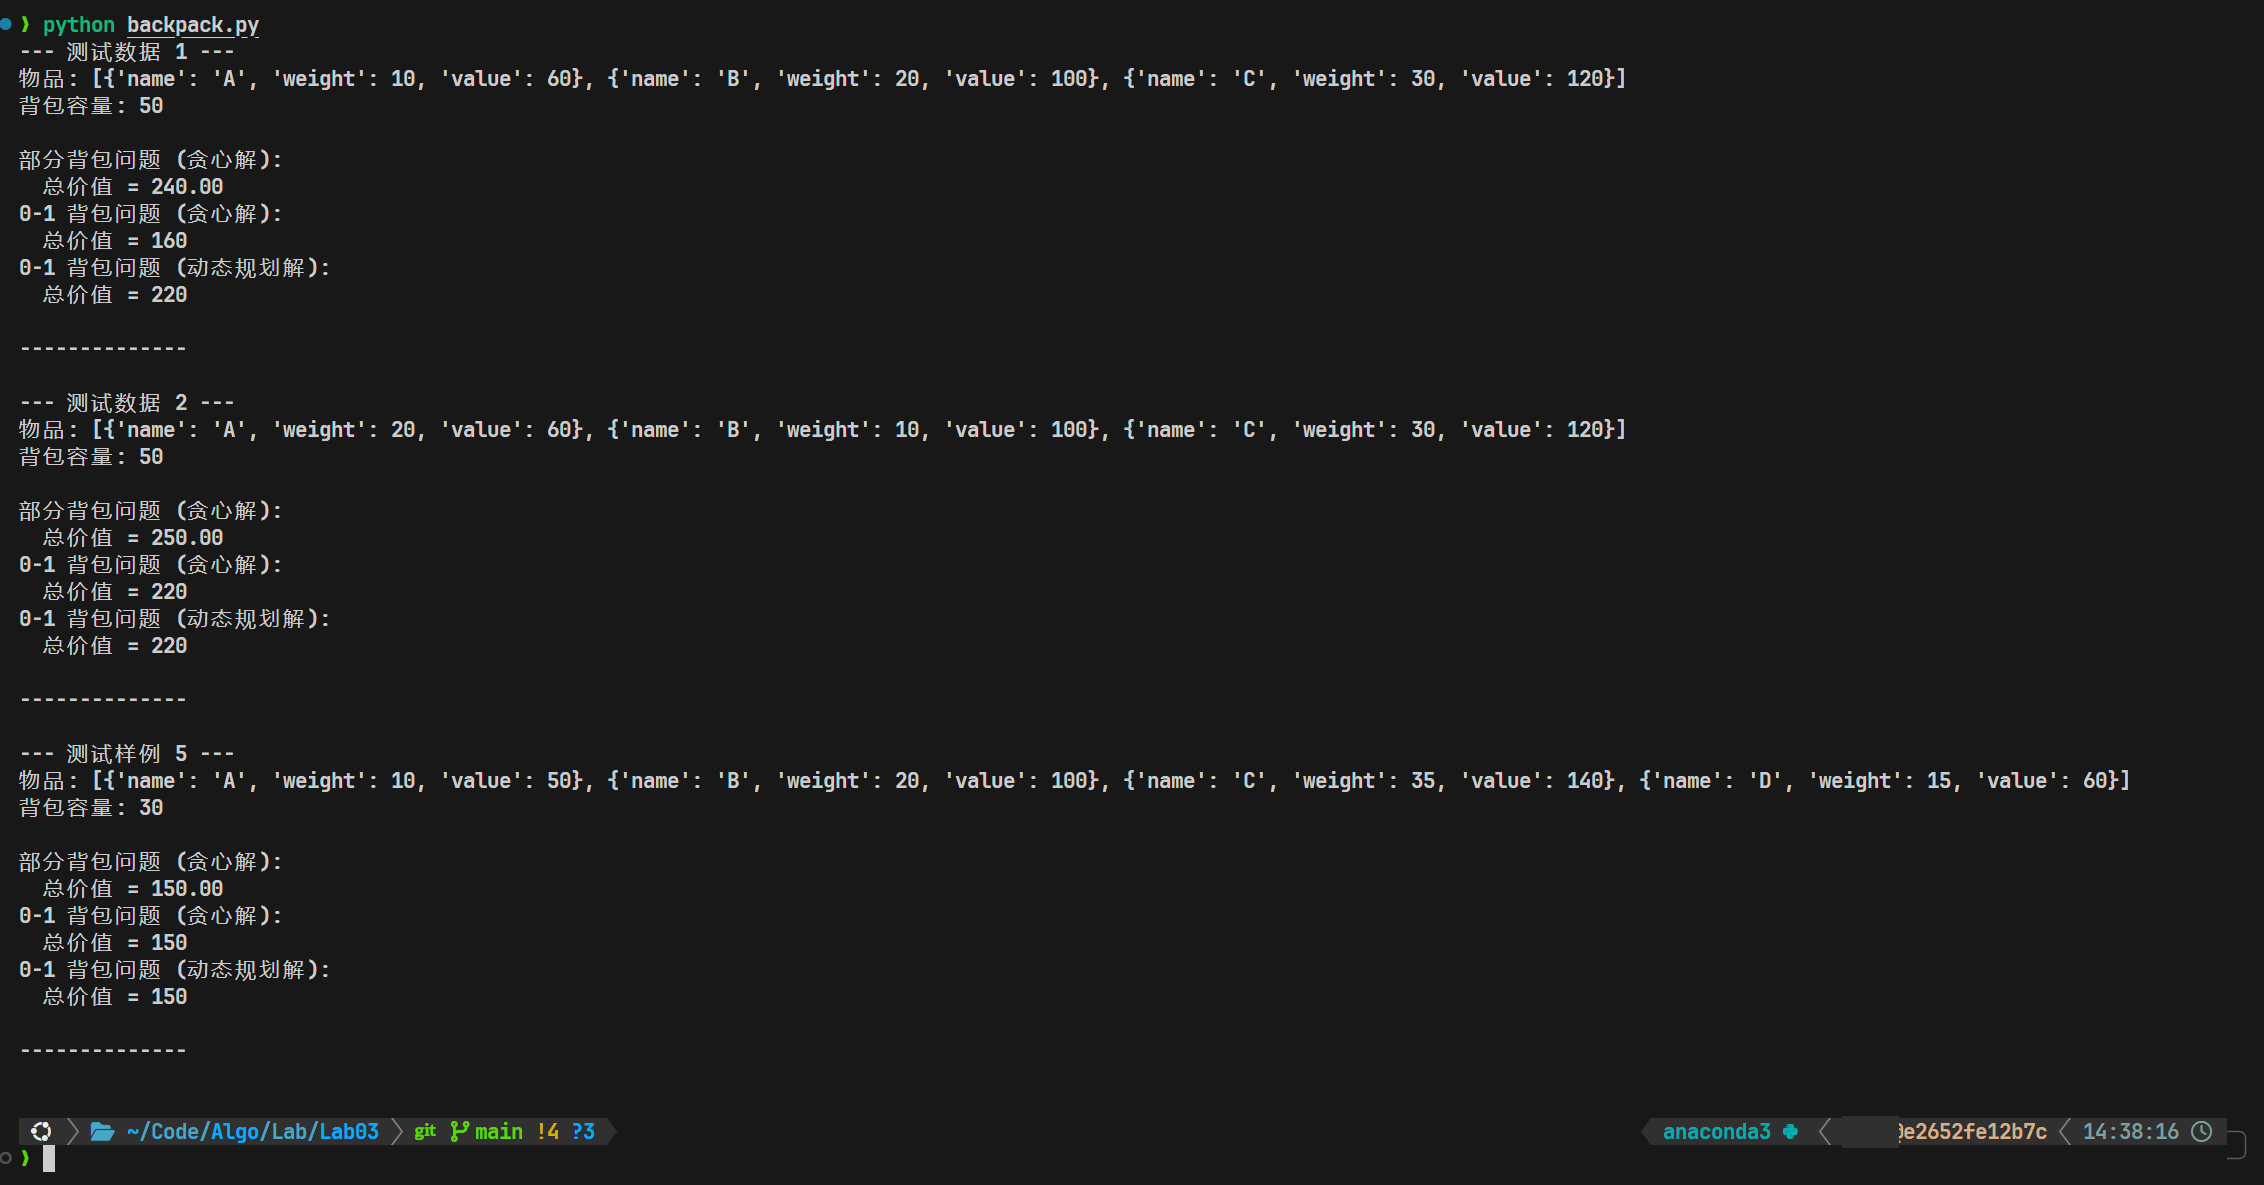
结论是: 当所有物品的单位价值(value/weight)相同时, 贪心算法能求得0-1背包问题的最优解
#### 2.2 最短等待时间问题
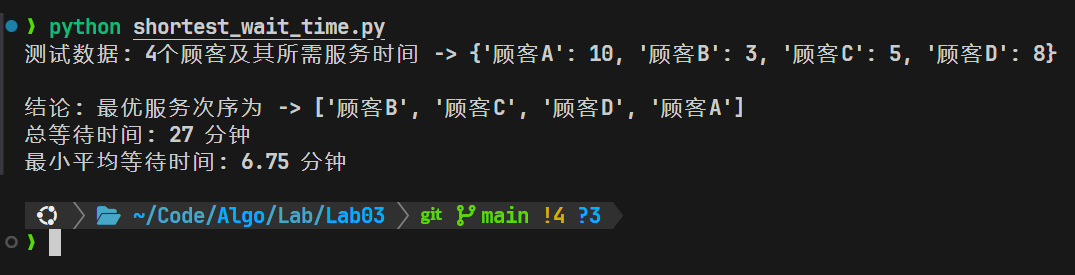
对于最短等待时间问题, 贪心算法总能得到最优解
---
### 3. 心得体会
通过本次实验,我对贪心算法的本质、适用场景和局限性有了更为深刻和具象化的理解。
**1.遇到的问题及解决方法**
* **问题一:如何有效证明贪心在0-1背包问题上是“错”的?**
* **遇到的问题**:仅凭一个例子说明贪心算法得不到最优解,似乎缺乏说服力。如何能确定真正的最优解是多少,从而进行有力的对比?
* **解决方法**:我意识到需要一个“参照物”。因此,我额外学习并实现了动态规划算法来求解0-1背包问题。因为动态规划能够保证得到最优解,所以它可以作为衡量贪心算法结果的“黄金标准”,使得对比分析非常清晰、有力。
* **问题二:如何证明调度问题的贪心策略是“对”的?**
* **遇到的问题**:“最短时间优先”这个策略非常直观,但直觉不等于证明。如何从逻辑上严格证明它的正确性?
* **解决方法**:我查阅了相关资料,学习了“邻项交换法”(Argument by Exchange)。通过假设存在一个非按最短时间排序的最优解,并证明通过交换其中一对“错误”顺序的相邻项总能使结果变得更好,从而产生矛盾,反证了原策略的正确性。这个过程锻炼了我的逻辑思维和数学证明能力。
**2.实验过程中的收获**
* **深刻理解了贪心算法的本质**:贪心算法的精髓在于“局部最优”,它在每一步都做出当下看起来最好的选择,并期望通过一系列局部最优得到全局最优。本次实验清晰地揭示了:对于某些问题(如背包问题、最短平均等待时间),这种策略是有效的;而对于另一些问题(如0-1背包问题),局部最优并不能导向全局最优。
* **掌握了判断贪心算法适用性的关键**:一个问题是否适用贪心算法,取决于它是否满足**贪心选择性质**和**最优子结构**。背包问题(可分割)满足这些性质,因为每次选择性价比最高的物品的一部分来填满剩余空间,这个选择不会影响后续决策,且总是正确的。而0-1背包问题则不满足贪心选择性质,因为当前的选择可能会“占用”掉一些容量,从而使得后续无法做出一个价值更高但组合方式不同的选择。
* **提升了算法设计和验证能力**:本次实验让我学会了不仅仅是实现一个算法,更要去设计实验来验证它、分析它。通过引入动态规划作为对比,以及运用数学方法证明算法的正确性,我的问题分析和解决能力得到了很好的锻炼。
总而言之,本次实验是一次非常成功的理论与实践的结合。它让我真正“看”到了算法的效率差异和适用边界,将书本上抽象的概念转化为了代码运行结果和严谨的逻辑分析,收获颇丰。
### 4. 附录
#### 4.1 背包问题
```python
def fractional_knapsack_greedy(items, capacity):
"""
使用贪心算法解决部分背包问题。
物品按单位价值从高到低排序。
"""
# 计算每个物品的单位价值
for item in items:
item['density'] = item['value'] / item['weight']
# 按单位价值降序排序
items.sort(key=lambda x: x['density'], reverse=True)
total_value = 0
knapsack = []
for item in items:
if capacity == 0:
break
if item['weight'] <= capacity:
# 可以完整放入
capacity -= item['weight']
total_value += item['value']
knapsack.append({'name': item['name'], 'weight': item['weight'], 'value': item['value']})
else:
# 只能放入一部分
fraction = capacity / item['weight']
total_value += item['value'] * fraction
knapsack.append({'name': item['name'], 'weight': capacity, 'value': item['value'] * fraction})
capacity = 0
return total_value, knapsack
def zero_one_knapsack_greedy(items, capacity):
"""
尝试使用贪心算法解决0-1背包问题。
"""
# 计算每个物品的单位价值
for item in items:
item['density'] = item['value'] / item['weight']
# 按单位价值降序排序
items.sort(key=lambda x: x['density'], reverse=True)
total_value = 0
knapsack = []
for item in items:
if capacity >= item['weight']:
capacity -= item['weight']
total_value += item['value']
knapsack.append(item)
return total_value, knapsack
def zero_one_knapsack_dp(items, capacity):
"""
使用动态规划解决0-1背包问题。
"""
n = len(items)
dp = [[0 for _ in range(capacity + 1)] for _ in range(n + 1)]
for i in range(1, n + 1):
weight = items[i-1]['weight']
value = items[i-1]['value']
for w in range(1, capacity + 1):
if weight > w:
dp[i][w] = dp[i-1][w]
else:
dp[i][w] = max(dp[i-1][w], dp[i-1][w - weight] + value)
return dp[n][capacity]
def run_test(test_name, items, capacity):
"""运行并打印一组测试数据的结果。"""
print(f"--- {test_name} ---")
print(f"物品: {items}")
print(f"背包容量: {capacity}\n")
# 贪心算法解决背包问题
fk_value, fk_knapsack = fractional_knapsack_greedy([item.copy() for item in items], capacity)
print(f"部分背包问题 (贪心解):")
print(f" 总价值 = {fk_value:.2f}")
# print(f" 包内物品: {fk_knapsack}\n")
# 贪心算法尝试解决0-1背包问题
g_value, g_knapsack = zero_one_knapsack_greedy([item.copy() for item in items], capacity)
print(f"0-1 背包问题 (贪心解):")
print(f" 总价值 = {g_value}")
# print(f" 包内物品: {[item['name'] for item in g_knapsack]}\n")
# 动态规划解决0-1背包问题
dp_value = zero_one_knapsack_dp([item.copy() for item in items], capacity)
print(f"0-1 背包问题 (动态规划解):")
print(f" 总价值 = {dp_value}\n")
print("-" * (len(test_name) + 8))
print()
# --- 测试数据 ---
items1 = [
{'name': 'A', 'weight': 10, 'value': 60},
{'name': 'B', 'weight': 20, 'value': 100},
{'name': 'C', 'weight': 30, 'value': 120},
]
capacity1 = 50
run_test("测试数据 1", items1, capacity1)
items2 = [
{'name': 'A', 'weight': 20, 'value': 60},
{'name': 'B', 'weight': 10, 'value': 100},
{'name': 'C', 'weight': 30, 'value': 120},
]
capacity2 = 50
run_test("测试数据 2", items2, capacity2)
items3 = [
{'name': 'A', 'weight': 12, 'value': 4},
{'name': 'B', 'weight': 2, 'value': 2},
{'name': 'C', 'weight': 1, 'value': 2},
{'name': 'D', 'weight': 1, 'value': 1},
{'name': 'E', 'weight': 4, 'value': 10},
]
capacity3 = 15
# run_test("测试数据 3", items3, capacity3)
items4 = [
{'name': 'A', 'weight': 20, 'value': 100},
{'name': 'B', 'weight': 30, 'value': 120},
]
capacity4 = 50
# run_test("测试样例 4", items4, capacity4)
items5 = [
{'name': 'A', 'weight': 10, 'value': 50},
{'name': 'B', 'weight': 20, 'value': 100},
{'name': 'C', 'weight': 35, 'value': 140},
{'name': 'D', 'weight': 15, 'value': 60}
]
capacity5 = 30
run_test("测试样例 5", items5, capacity5)
```
#### 4.2 最短平均等待时间问题
```python
def shortest_average_wait_time_solver(customers):
"""
使用贪心策略解决最短平均等待时间问题。
"""
# 核心贪心策略:按服务时间从小到大排序
# items()返回(key, value)对,x[1]表示按服务时间排序
sorted_customers = sorted(customers.items(), key=lambda x: x[1])
optimal_order = [customer[0] for customer in sorted_customers]
total_wait_time = 0
current_wait_time = 0 # 记录当前顾客的等待时间
# 计算总等待时间
# 第一个顾客等待时间为0
# 第二个顾客等待时间为第一个的服务时间
# 第三个顾客等待时间为前两个的服务时间之和,依此类推
for i in range(len(sorted_customers) - 1):
current_wait_time += sorted_customers[i][1] # 完成当前顾客服务后,累加到下一个顾客的等待时间上
total_wait_time += current_wait_time
n = len(customers)
average_wait_time = total_wait_time / n if n > 0 else 0
return optimal_order, total_wait_time, average_wait_time
if __name__ == "__main__":
customers_data = {
'顾客A': 10, # 需要10分钟服务
'顾客B': 3,
'顾客C': 5,
'顾客D': 8
}
print(f"测试数据: {len(customers_data)}个顾客及其所需服务时间 -> {customers_data}")
order, total_wait, avg_wait = shortest_average_wait_time_solver(customers_data)
print(f"\n结论: 最优服务次序为 -> {order}")
print(f"总等待时间: {total_wait} 分钟")
print(f"最小平均等待时间: {avg_wait:.2f} 分钟")
```
# 实验 4
## 一、实验名称
递归与分治
## 二、实验目的及要求
通过本次实验课学习,掌握贪心算法求解优化问题的一般步骤,并理解贪心策略在求解优化问题的关键作用。
## 三、实验环境
ubuntu-24.04 x86_64 5.14.0-503.11.1.el9_5.x86_64
gcc version 11.4.0 (Ubuntu 11.4.0-9ubuntu1)
## 四、实验设计
### 1. 实验步骤
#### **N-后问题设计**
N-后问题的本质是在一个N×N的棋盘上,逐行放置皇后,并确保任何新放置的皇后不与已放置的皇后在同一列或同一对角线上。这是一个典型的组合搜索问题,非常适合用回溯法来探索解空间。
**1. 递归回溯法**
* **核心思想**:深度优先搜索解空间树。从第0行开始,尝试为当前行 `row` 的每一列 `col` 放置皇后。如果当前位置 `(row, col)` 安全,则将皇后放置于此,并递归地进入下一行 `row + 1` 进行决策。如果下一行的所有尝试都失败了,函数会自动返回,程序会继续尝试当前行 `row` 的下一列 `col + 1`,这就构成了“回溯”。
* **流程图**
```mermaid
graph TD
A("开始: solve(row=0)") --> B{"row == N?"};
B -- 是 --> C["找到一个解, 存储并返回"];
B -- 否 --> D("循环 col 从 0 到 N-1");
D --> E{"位置(row, col)安全?"};
E -- 是 --> F["放置皇后 queens[row] = col"];
F --> G("递归调用 solve(row + 1)");
G --> D;
E -- 否 --> D;
D -- 循环结束 --> H("返回上一层");
```
**2. 迭代回溯法**
* **核心思想**:用循环和自定义的状态变量来模拟递归调用的过程,从而避免使用系统调用栈。关键在于如何手动管理“前进”和“回溯”的逻辑。
* **状态管理**:使用一个变量 `row` 表示当前正在处理的行。当 `row` 增加时,表示向深层“递归”;当 `row` 减少时,表示“回溯”。回溯后,必须从上一行皇后**之前位置的下一列**开始继续搜索,这是迭代实现的核心。
* **流程图**
```mermaid
graph TD
A("开始, row=0") --> B{"while row >= 0"};
B -- 是 --> C{"row == N?"};
C -- 是 --> D["找到解, 存储"];
D --> E("回溯: row--");
C -- 否 --> F("寻找当前row的安全列col");
F -- 从row+1或0开始 --> G{"找到安全列?"};
G -- 是 --> H["放置皇后 queens[row]=col"];
H --> I("前进: row++");
I --> B;
G -- 否 --> J("重置当前行: queens[row]=-1");
J --> E;
B -- 否 --> K("结束");
```
#### **单源最短路径问题设计**
* **算法思想理解**:分支限界法是一种在问题的解空间树上进行广度优先或最佳优先搜索的算法,通常用于求解优化问题。当应用于单源最短路径问题时,其“最佳优先”的搜索策略与著名的 **Dijkstra 算法** 完全一致。
* **核心策略**:算法维护一个从源点 `source` 到各个顶点的距离集合。它总是从“待考察”的顶点中,选择一个当前距离源点最近的顶点 `u` 进行扩展(分支)。然后,通过顶点 `u` 更新其所有邻接顶点 `v` 的距离(松弛操作)。如果到达 `v` 的新路径比已知路径更短,就更新它。这个过程不断重复,直到所有可达顶点都被考察完毕。
* **关键数据结构**:为了高效地实现“选择距离最近的顶点”,**优先队列(最小堆)** 是不二之选。
* **流程图**
```mermaid
graph TD
A("开始") --> B["初始化所有距离为∞, 源点为0"];
B --> C["将 (0, source) 推入优先队列PQ"];
C --> D{"while PQ不为空"};
D -- 是 --> E["从PQ弹出距离最小的顶点 (d, u)"];
E --> F{"d > 已记录的dist[u]?"};
F -- 是旧数据 --> D;
F -- 否 --> G("遍历u的所有邻居v");
G --> H{"通过u到达v的距离 < 已记录的dist[v]?"};
H -- 是 --> I("更新dist[v], 将新(dist, v)推入PQ");
I --> G;
H -- 否 --> G;
G -- 循环结束 --> D;
D -- 否 --> J("结束, 返回所有最短距离");
```
---
### 2. 调试过程及实验结果
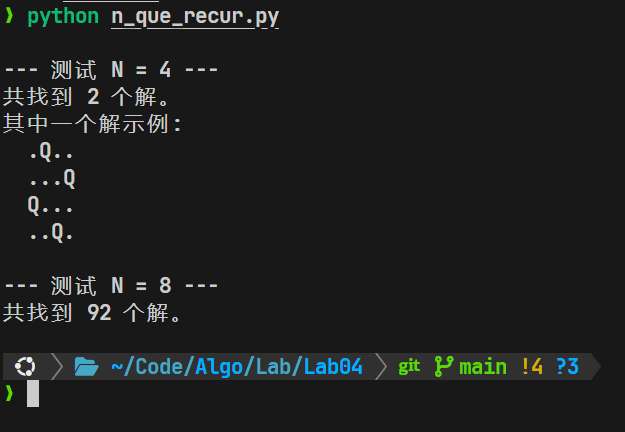
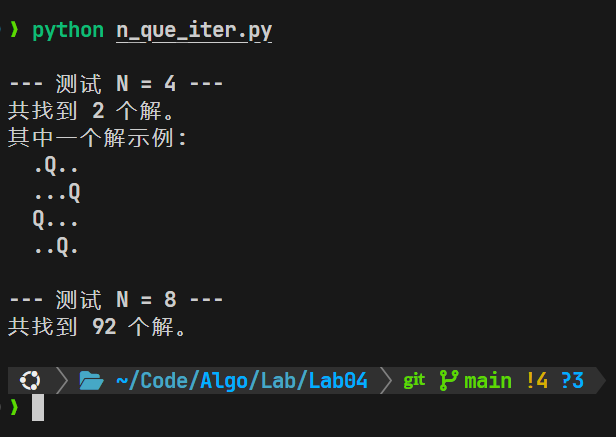
#### **N-后问题**
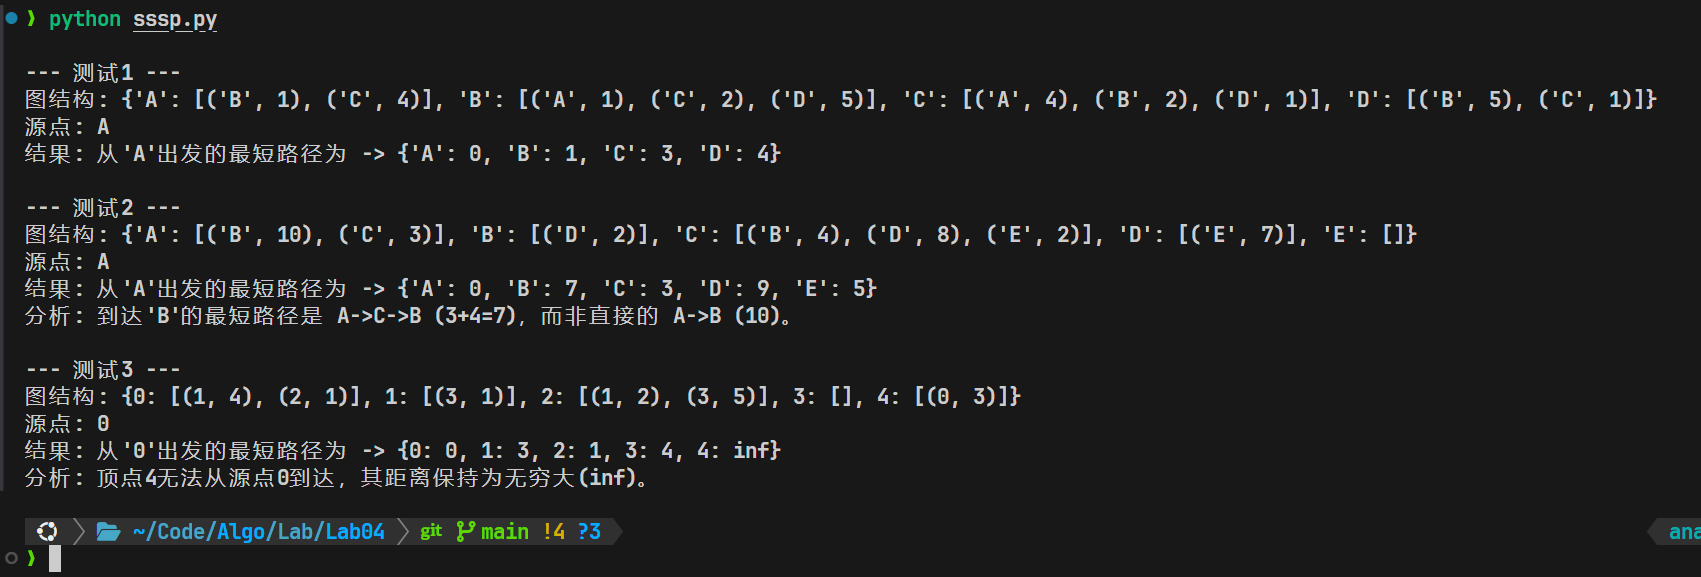
#### **单源最短路径问题**
**测试数据集**
| 测试名称 | 图结构 (邻接表) | 源点 | 目标与分析 |
| :-------- | :--------------------------------------------------- | :--- | :--------------------------------------------------------- |
| **测试1** | `{'A': [('B', 1), ('C', 4)], 'B': ..., 'C': ...}` | 'A' | 标准情况,验证基本功能 |
| **测试2** | `{'A': [('B', 10), ('C', 3)], 'C': [('B', 4)], ...}` | 'A' | 验证算法能否找到经过更多顶点的更短路径 (A->C->B 短于 A->B) |
| **测试3** | 包含孤立顶点 `4` | `0` | 验证算法能否正确处理不连通图的情况 |
---
### 3. 心得体会
通过本次实验,我对回溯法和分支限界法这两种核心算法思想有了更具体、更深入的认识。
**1. 遇到的问题及解决方法**
* **问题一:如何将N-后问题的递归思路转化为迭代?**
* **遇到的问题**:递归的实现非常自然,但要转换成迭代,核心难点在于如何模拟“回溯”后,从上一个状态的“下一个选择”继续。简单地 `row--` 之后,如果内层循环还是从 `col=0` 开始,就会陷入死循环。
* **解决方法**:我意识到必须记录每一行做出选择时的列号。在 `queens` 数组中,`queens[row]` 的值本身就记录了这一信息。因此,当从 `row+1` 回溯到 `row` 时,下一次列的循环必须从 `queens[row] + 1` 开始,这完美地模拟了递归函数返回后继续执行 `for` 循环的逻辑。
* **问题二:“分支限界法”与“Dijkstra”的关系是什么?**
* **遇到的问题**:课本中提到用分支限界法解最短路径,但其描述与Dijkstra算法非常相似,这让我感到困惑。
* **解决方法**:通过查阅资料和编码实践,我最终理解到,Dijkstra算法可以被看作是分支限界法在单源最短路径问题上的一个特例。分支限界法的核心是“扩展最有希望的节点”,在SSSP问题中,“最有希望”的节点就是“当前距离源点最近”的节点。优先队列恰好是实现这一“最佳优先”搜索策略的完美工具。想通了这一点,算法的设计就变得非常清晰了。
**2. 实验过程中的收获**
* **深化了对回溯法的理解**:亲手实现递归和迭代两种版本后,我对回溯法“选择-约束-递归-回溯”的循环有了本质的认识。迭代的实现过程让我更清晰地看到了算法在解空间树上深度优先搜索和剪枝的过程,以及系统调用栈在递归中扮演的角色。
* **掌握了算法思想的统一性**:将分支限界法应用到最短路径问题,让我看到不同算法范式之间的内在联系。与其死记硬背某个特定算法的步骤,不如理解其所属的更广泛的算法思想(如“最佳优先搜索”),这样在面对新问题时,就能更灵活地设计出解决方案。
* **数据结构的重要性**:本次实验再次印证了数据结构是算法的基石。无论是N-后问题中用一维数组巧妙表示二维棋盘状态,还是在分支限界法中利用优先队列(最小堆)将 $O(V^2)$ 的朴素搜索优化到 $O(E \log V)$,都体现了选择合适的数据结构对算法效率的决定性作用。
### 4. 附录
#### 4.1 N-后问题: 递归回溯法
```python
def solve_n_queens_recursive(n):
"""
使用递归回溯解决N-后问题。
"""
solutions = []
# queens[row] = col 表示在第row行第col列放置了一个皇后
queens = [-1] * n
def is_safe(row, col):
"""
检查在(row, col)位置放置皇后是否安全。
只需检查当前行之前的所有行。
"""
for r in range(row):
# 检查是否在同一列
if queens[r] == col:
return False
# 检查是否在同一对角线
if abs(row - r) == abs(col - queens[r]):
return False
return True
def solve(row):
"""
递归地为从row行开始的棋盘布局寻找解。
"""
# 基线条件:如果所有行都已成功放置皇后,则找到一个解
if row == n:
# 格式化解并存储
solution = []
for r in range(n):
row_str = ['.'] * n
row_str[queens[r]] = 'Q'
solution.append("".join(row_str))
solutions.append(solution)
return
# 尝试在当前行的每一列放置皇后
for col in range(n):
if is_safe(row, col):
# 做出选择
queens[row] = col
# 进入下一行决策
solve(row + 1)
# 回溯在此实现中是隐式的,下一次循环会自动覆盖 queens[row]
# 从第0行开始求解
solve(0)
return solutions
if __name__ == "__main__":
# --- 测试 N=4 ---
N4 = 4
print(f"\n--- 测试 N = {N4} ---")
solutions_4 = solve_n_queens_recursive(N4)
print(f"共找到 {len(solutions_4)} 个解。")
if solutions_4:
print("其中一个解示例:")
for row_str in solutions_4[0]:
print(f" {row_str}")
# --- 测试 N=8 (标准测试) ---
N8 = 8
print(f"\n--- 测试 N = {N8} ---")
solutions_8 = solve_n_queens_recursive(N8)
print(f"共找到 {len(solutions_8)} 个解。")
```
#### 4.2 N-后问题: 迭代回溯法
```python
def solve_n_queens_iterative(n):
"""
使用迭代回溯(非递归)解决N-后问题。
"""
solutions = []
# queens[row] = col 表示在第row行第col列放置了一个皇后
queens = [-1] * n
def is_safe(row, col):
"""
检查在(row, col)位置放置皇后是否安全。
"""
for r in range(row):
if queens[r] == col or abs(row - r) == abs(col - queens[r]):
return False
return True
row = 0
while row >= 0:
# 如果成功为所有行都找到了位置,说明找到一个完整解
if row == n:
# 格式化解并存储
solution = []
for r in range(n):
row_str = ['.'] * n
row_str[queens[r]] = 'Q'
solution.append("".join(row_str))
solutions.append(solution)
# 回溯到上一行,继续寻找下一个可能的解
row -= 1
# continue关键字可以省略,因为循环会自然地继续
# 为当前行寻找一个安全的位置
# col的起始位置是关键:如果是新进入的行,从0开始;如果是回溯回来的行,从上一个位置的下一个开始
start_col = queens[row] + 1 if queens[row] != -1 else 0
found_safe_pos = False
for col in range(start_col, n):
if is_safe(row, col):
# 做出选择
queens[row] = col
# 成功,移动到下一行
row += 1
found_safe_pos = True
break # 找到了当前行的位置,跳出列循环,进入下一行
# 如果当前行的所有列都尝试完毕,仍未找到安全位置
if not found_safe_pos:
queens[row] = -1 # 重置当前行的选择
row -= 1 # 回溯到上一行
return solutions
if __name__ == "__main__":
# --- 测试 N=4 ---
N4 = 4
print(f"\n--- 测试 N = {N4} ---")
solutions_4 = solve_n_queens_iterative(N4)
print(f"共找到 {len(solutions_4)} 个解。")
if solutions_4:
print("其中一个解示例:")
for row_str in solutions_4[0]:
print(f" {row_str}")
# --- 测试 N=8 (标准测试) ---
N8 = 8
print(f"\n--- 测试 N = {N8} ---")
solutions_8 = solve_n_queens_iterative(N8)
print(f"共找到 {len(solutions_8)} 个解。")
```
#### 4.3 单源最短路径: 分支限界法
```python
import heapq
def branch_and_bound_sssp(graph, source):
"""
使用分支限界法(Dijkstra算法)解决单源最短路径问题。
"""
# 初始化距离数组,所有顶点距离为无穷大,源点为0
distances = {vertex: float('inf') for vertex in graph}
if source not in distances:
raise KeyError(f"源点 {source} 不在图中!")
distances[source] = 0
# 优先队列,存储 (距离, 顶点),距离越小优先级越高
priority_queue = [(0, source)]
while priority_queue:
# 弹出当前距离最小的顶点(分支限界法的“限界”选择)
current_distance, current_vertex = heapq.heappop(priority_queue)
# 如果弹出的距离比记录的距离大,说明是旧的、较长的路径,跳过
if current_distance > distances[current_vertex]:
continue
# 遍历当前顶点的所有邻居(分支过程)
for neighbor, weight in graph.get(current_vertex, []):
distance = current_distance + weight
# 如果通过当前顶点到达邻居的路径更短(松弛操作)
if distance < distances[neighbor]:
distances[neighbor] = distance
# 将更新后的邻居加入优先队列
heapq.heappush(priority_queue, (distance, neighbor))
return distances
if __name__ == "__main__":
# --- 测试数据 1: 标准情况 ---
graph1 = {
'A': [('B', 1), ('C', 4)],
'B': [('A', 1), ('C', 2), ('D', 5)],
'C': [('A', 4), ('B', 2), ('D', 1)],
'D': [('B', 5), ('C', 1)]
}
source1 = 'A'
print(f"\n--- 测试1 ---")
print(f"图结构: {graph1}")
print(f"源点: {source1}")
shortest_paths1 = branch_and_bound_sssp(graph1, source1)
print(f"结果: 从'{source1}'出发的最短路径为 -> {shortest_paths1}")
# --- 测试数据 2: 包含更长但权重更低的路径 ---
graph2 = {
'A': [('B', 10), ('C', 3)],
'B': [('D', 2)],
'C': [('B', 4), ('D', 8), ('E', 2)],
'D': [('E', 7)],
'E': []
}
source2 = 'A'
print(f"\n--- 测试2 ---")
print(f"图结构: {graph2}")
print(f"源点: {source2}")
shortest_paths2 = branch_and_bound_sssp(graph2, source2)
print(f"结果: 从'{source2}'出发的最短路径为 -> {shortest_paths2}")
print("分析: 到达'B'的最短路径是 A->C->B (3+4=7),而非直接的 A->B (10)。")
# --- 测试数据 3: 包含不连通的顶点 ---
# 顶点4无法从0到达
graph3_data = {
0: [(1, 4), (2, 1)],
1: [(3, 1)],
2: [(1, 2), (3, 5)],
3: [],
4: [(0, 3)]
}
# 确保图的定义中包含所有顶点,即使它们没有出边
all_vertices = {0, 1, 2, 3, 4}
graph3 = {v: graph3_data.get(v, []) for v in all_vertices}
source3 = 0
print(f"\n--- 测试3 ---")
print(f"图结构: {graph3}")
print(f"源点: {source3}")
shortest_paths3 = branch_and_bound_sssp(graph3, source3)
print(f"结果: 从'{source3}'出发的最短路径为 -> {shortest_paths3}")
print("分析: 顶点4无法从源点0到达,其距离保持为无穷大(inf)。")
```